Tên miền mất A record: hậu quả dây chuyền lên SEO, email và thanh toán
Có những sự cố mà bạn phát hiện qua dashboard. Và có những sự cố mà bạn phát hiện qua tin nhắn Zalo của khách, lúc 6 giờ 40 sáng.
Sự việc xảy ra với một hệ thống đang chạy thật: một bản ghi DNS bị xoá. Không ai xoá nó. Không ai deploy gì. Nó chỉ đơn giản là biến mất — và trong vòng 15 phút, bốn thứ khác nhau cùng hỏng theo: website, email giao dịch, webhook thanh toán, và API cho ứng dụng desktop.
Điều đáng sợ nhất không phải là sự cố. Điều đáng sợ là thời gian từ lúc hỏng đến lúc biết là 4 giờ 26 phút, và trong suốt khoảng đó, hệ thống vẫn trả về một trang lỗi trông có vẻ bình thường.
Bài này viết về hậu quả dây chuyền của một bản ghi DNS bị mất: cái gì hỏng trước, cái gì hỏng sau, vì sao hậu quả lớn hơn bạn nghĩ, cách chẩn đoán trong 5 phút, và cách phòng để lần sau bạn biết trước khi khách biết.
1. A record làm gì, và làm sao nó "mất"
Trước khi nói về hậu quả, cần thống nhất một điều đơn giản mà nhiều người làm kỹ thuật vẫn hiểu mơ hồ.
A record là bản ghi ánh xạ một tên miền sang một địa chỉ IP. Khi ai đó gõ chuyendoiso.digital vào trình duyệt, máy tính phải trả lời câu hỏi: "tên này tương ứng với IP nào?" A record chính là câu trả lời đó.
Một hệ sinh thái nhỏ thường có ít nhất năm nhóm bản ghi quan trọng:
| Loại | Trỏ tới | Dùng cho |
|---|---|---|
A | IPv4 của máy chủ | Website, API |
AAAA | IPv6 | Tương tự A, phiên bản IPv6 |
CNAME | Một tên miền khác | Subdomain, CDN |
MX | Máy chủ email | Nhận email |
TXT | Chuỗi văn bản | SPF, DKIM, DMARC, xác minh dịch vụ |
Trong sự cố tôi kể ở trên, cái mất là một A record của subdomain API. Không phải bản ghi của trang chủ. Nên trang chủ vẫn mở bình thường — và đó chính là lý do sự cố không ai phát hiện.
Vì sao bản ghi "tự nhiên" mất
Người ta hay tưởng DNS chỉ thay đổi khi có người sửa. Thực tế có năm nguyên nhân phổ biến, và chỉ một trong số đó là do con người:
Thứ nhất, chuyển nhà cung cấp DNS. Bạn đổi nameserver từ nhà cung cấp này sang nhà cung cấp khác, nhưng không export toàn bộ zone file. Bản ghi nào ít dùng thì bị quên. Đây là nguyên nhân số một.
Thứ hai, bản ghi phụ thuộc một dịch vụ bên ngoài. Bạn tạo CNAME trỏ tới một dịch vụ hosting. Dịch vụ đó đổi tên miền nội bộ, và bản ghi của bạn trỏ vào hư không.
Thứ ba, IP của máy chủ thay đổi. Nhà cung cấp VPS đổi hạ tầng, cấp IP mới. Bản ghi vẫn trỏ về IP cũ — nơi giờ không có gì lắng nghe.
Thứ tư, hết hạn tên miền. Ít gặp hơn nhưng hậu quả nặng nhất, vì khi đó toàn bộ bản ghi biến mất, không chỉ một cái.
Thứ năm, vô tình xoá khi dọn dẹp. Một buổi chiều ai đó vào bảng điều khiển DNS "dọn bản ghi cũ", và xoá nhầm một dòng không rõ mục đích.
Điểm chung của cả năm: không có bản ghi nào tự báo cho bạn biết nó đã biến mất.
2. Bốn tầng hậu quả, và thứ tự chúng hỏng
Điều làm sự cố DNS khác với sự cố máy chủ là tính dây chuyền. Một bản ghi mất đi kéo theo nhiều hệ thống con hỏng, nhưng chúng hỏng không cùng lúc và không cùng mức độ ồn ào.
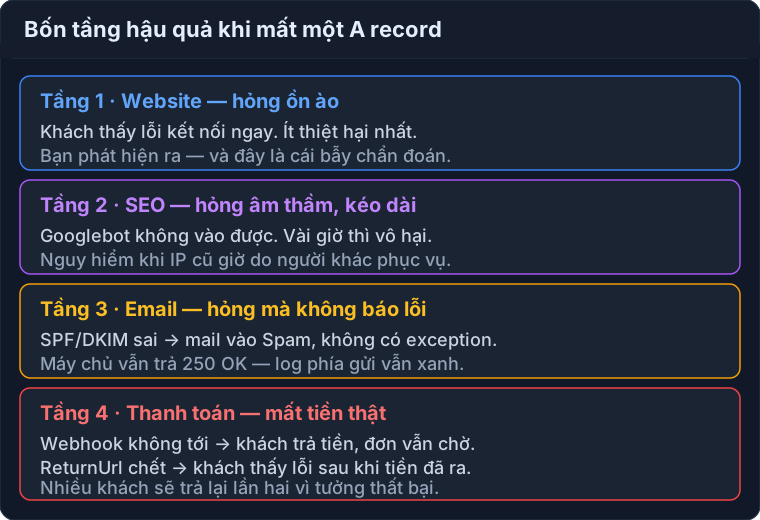
Tầng 1 — Website: hỏng ồn ào nhưng vô hại nhất
Đây là tầng hỏng đầu tiên và cũng là tầng duy nhất mà bạn sẽ nhận ra ngay. Trình duyệt trả về lỗi kết nối. Google Search Console bắt đầu gửi cảnh báo "URL không truy cập được".
Điều trớ trêu: đây là tầng ít thiệt hại nhất. Khách không vào được web thì họ thử lại sau. Không ai mất tiền trong 30 phút website chết.
Nhưng tầng này là nguyên nhân khiến nhiều người dừng việc chẩn đoán quá sớm: họ sửa xong website, thấy nó chạy, và kết luận "đã ổn". Trong khi ba tầng còn lại vẫn đang hỏng.
Tầng 2 — SEO: hỏng âm thầm và kéo dài
Googlebot không vào được site nghĩa là không có gì được index. Nhưng đây là điểm quan trọng mà nhiều người hiểu sai:
Mất vài giờ không làm bạn mất thứ hạng. Google xử lý sự cố tạm thời khá kiên nhẫn. Nếu site trở lại trong vài giờ, thứ hạng gần như không đổi.
Cái thực sự gây hại là bản ghi sai trỏ về một máy chủ khác — ví dụ IP cũ giờ thuộc về người khác. Khi đó Googlebot vẫn vào được, nhưng nó thấy một trang hoàn toàn khác. Lúc đó bạn không bị coi là "đang gặp sự cố", bạn bị coi là đã đổi nội dung. Và hậu quả có thể là mất thứ hạng trong nhiều tháng.
Đây là lý do một trong những việc quan trọng nhất khi mất A record là kiểm tra IP cũ giờ thuộc về ai, chứ không chỉ trỏ lại đúng.
Tầng 3 — Email: hỏng theo cách khó nhất để nhận ra
Đây là tầng tôi lo nhất, và cũng là tầng nhiều người quên nhất.
Khi bạn gửi email từ tên miền của mình, máy chủ nhận sẽ kiểm tra ba thứ:
- SPF — bản ghi TXT liệt kê những máy chủ được phép gửi thay tên miền của bạn
- DKIM — chữ ký số, thường là một bản ghi TXT tại selector cụ thể
- DMARC — chính sách nói phải làm gì khi hai cái trên thất bại
Nếu A record của subdomain dùng để gửi email bị mất, hoặc nếu bạn chuyển DNS và quên mang theo bản ghi DKIM, chữ ký sẽ không xác minh được. Kết quả:
Email vẫn được gửi đi. Không có lỗi. Không có ngoại lệ. Máy chủ SMTP trả về 250 OK, đúng như mọi lần thành công khác.
Nhưng email vào hộp thư rác, hoặc bị chặn hẳn ở phía người nhận. Và bạn không biết, vì phía gửi không thấy gì bất thường.
Tôi từng mất gần một ngày cho một sự cố loại này: hệ thống gửi email xác thực đăng ký, log ghi "gửi thành công" cho từng email, mà không có học viên nào nhận được mã. Phải đến khi một người gọi điện hỏi mới biết.
Bài học: `250 OK` không có nghĩa là email đã tới hộp thư. Nó chỉ có nghĩa là máy chủ trung chuyển đã nhận. Với email giao dịch, bạn cần một kênh kiểm tra độc lập — không phải log của chính mình.
Tầng 4 — Thanh toán: hỏng theo hướng nguy hiểm nhất
Đây là tầng có thể làm bạn mất tiền thật, và nó xảy ra theo một trong hai kịch bản.
Kịch bản một — webhook không tới. Cổng thanh toán gọi vào https://api.tenmien.com/webhook. DNS không giải được tên đó, nên cuộc gọi thất bại. Cổng thanh toán thử lại theo lịch của họ — thường là vài lần trong vài giờ — rồi dừng. Khách đã trả tiền, đơn hàng vẫn ở trạng thái chờ, và dịch vụ không được kích hoạt.
Kịch bản hai, nguy hiểm hơn — ReturnUrl trỏ sai chỗ. Khách trả tiền xong, cổng thanh toán chuyển hướng họ về một URL. Nếu URL đó không tải được, khách thấy trang lỗi ngay sau khi tiền đã ra khỏi tài khoản. Phần lớn khách sẽ hiểu là "giao dịch thất bại" — và một số sẽ trả lại lần thứ hai.
Điều đáng nói: kịch bản hai không phải lỗi của DNS. Nhưng nó lộ ra cùng lúc với sự cố DNS, và làm mọi thứ rối hơn nhiều khi bạn đang cố chẩn đoán.
3. Vì sao sự cố DNS kéo dài lâu hơn bạn tưởng
Có một chi tiết kỹ thuật khiến loại sự cố này khác biệt: DNS có bộ nhớ đệm.
Khi bạn sửa bản ghi, thế giới không thấy ngay. Mỗi bản ghi có một TTL (Time To Live) — thời gian mà máy chủ DNS trung gian được phép nhớ câu trả lời cũ. TTL phổ biến là 300 giây, 3600 giây, hoặc 86400 giây (một ngày).
Nghĩa là: thời gian khắc phục sự cố DNS bằng thời gian sửa cộng thời gian TTL. Nếu TTL là 24 giờ, bạn có thể đã sửa đúng nhưng vẫn còn hàng trăm nghìn người dùng nhận câu trả lời cũ.
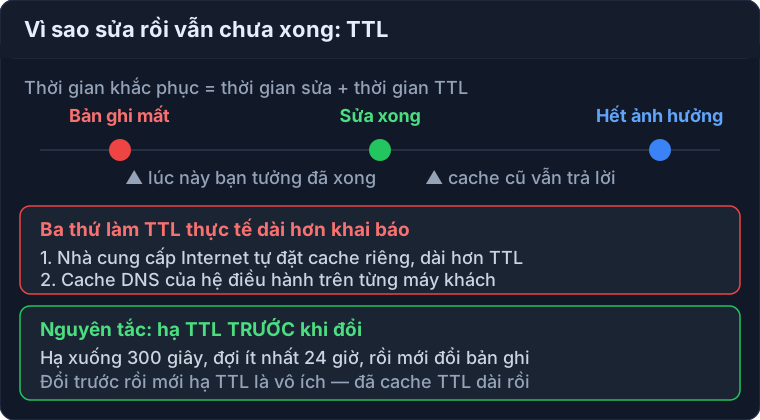
Thực tế tệ hơn một chút, vì ba lý do:
Thứ nhất, một số nhà cung cấp dịch vụ Internet không tôn trọng TTL. Họ tự đặt thời gian cache riêng, có khi dài hơn cả TTL bạn khai báo.
Thứ hai, DNS của hệ điều hành có cache riêng. Windows và macOS đều cache câu trả lời. Sửa DNS trên máy chủ không xoá cache trên máy khách.
Thứ ba, có nhiều máy chủ DNS đệ quy khác nhau trên thế giới, mỗi cái có cache riêng với thời điểm hết hạn khác nhau. Không có "một lúc" mà tất cả cùng cập nhật.
Đây là lý do một quy tắc vận hành quan trọng: hạ TTL trước khi đổi, không phải sau khi đổi. Nếu bạn biết mình sắp chuyển máy chủ, hãy hạ TTL xuống 300 giây trước đó ít nhất 24 giờ, để lúc đổi, toàn thế giới đã quen với TTL ngắn.
Làm ngược lại — đổi bản ghi rồi mới hạ TTL — không giúp gì, vì lúc đó các máy chủ đã cache câu trả lời cũ với TTL dài.
4. Chẩn đoán trong 5 phút
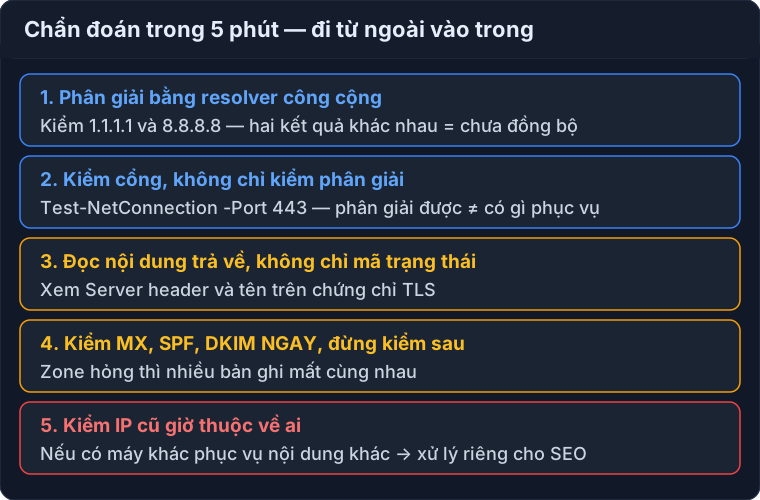
Khi hệ thống có dấu hiệu hỏng và bạn nghi ngờ DNS, đây là trình tự tôi dùng. Nó cố tình đi từ ngoài vào trong, để loại trừ nhanh.
Bước 1 — Tên miền có phân giải được không?
# Phân giải bằng DNS công cộng, không dùng cache của máy
Resolve-DnsName api.example.com -Server 1.1.1.1 -Type A

# Và so sánh với DNS thứ hai — hai cái trả lời khác nhau là dấu hiệu cache chưa đồng bộ
Resolve-DnsName api.example.com -Server 8.8.8.8 -Type A
Nếu hai máy chủ DNS trả về hai IP khác nhau, bạn đang ở giữa quá trình lan truyền — không phải lỗi, chỉ là cần chờ.
Bước 2 — IP trả về có thật sự phục vụ không?
# Kiểm tra cổng, không chỉ kiểm tra phân giải
Test-NetConnection api.example.com -Port 443
Đây là bước nhiều người bỏ qua. Tên miền phân giải được không có nghĩa là có gì đó đang lắng nghe ở đầu bên kia. Và như đã nói ở tầng SEO: nếu có một máy khác đang lắng nghe, bạn còn không biết mình đang gặp may hay gặp họa.
Bước 3 — Nhìn câu trả lời HTTP, không chỉ trạng thái kết nối.
$r = Invoke-WebRequest "https://api.example.com/health" -SkipHttpErrorCheck
"HTTP $($r.StatusCode)"
$r.Headers['Server']
Chứng chỉ TLS là dấu hiệu tốt để phát hiện trỏ sai: nếu bạn kết nối được nhưng chứng chỉ mang tên miền khác, bạn đang nói chuyện với máy chủ của người khác.
Bước 4 — Kiểm tra bản ghi email cùng lúc, đừng kiểm tra sau.
Resolve-DnsName example.com -Type MX
Resolve-DnsName example.com -Type TXT | Select-Object Strings
Resolve-DnsName selector._domainkey.example.com -Type TXT
Thói quen này quan trọng: kiểm tra MX, SPF và DKIM ngay khi kiểm tra A record. Vì khi zone file bị hỏng, nhiều bản ghi thường mất cùng nhau — và nếu bạn chỉ sửa A record rồi đóng sự cố, email sẽ hỏng âm thầm trong nhiều ngày sau đó.
Bước 5 — Xem lại IP cũ.
# IP cũ giờ thuộc về ai?
# Kiểm tra bằng nslookup ngược hoặc tra cứu whois
Nếu IP cũ giờ thuộc một máy chủ khác đang phục vụ nội dung khác, bạn cần biết ngay — vì đó là tình huống có thể đã gây hại cho SEO, và cần xử lý riêng ngoài việc sửa bản ghi.
5. Tôi đã chẩn đoán sai thế nào
Phần này là phần tôi thấy cần viết nhất, vì danh sách "cách làm đúng" không dạy được cảm giác của người đã làm sai.
Sai lầm thứ nhất: tôi tin vào cache của chính mình.
Sau khi sửa bản ghi, tôi mở trình duyệt và thấy website hoạt động. Tôi kết luận đã xong.
Thực tế: máy tôi vừa resolve tên miền đó vài phút trước khi sửa, nên nó còn giữ câu trả lời trong cache. Nó đang phục vụ tôi câu trả lời cũ — hoặc mới, tôi không biết. Tôi chỉ kiểm tra bằng một máy, với một bộ đệm, không xoá gì.
Cách tôi làm bây giờ: luôn kiểm tra bằng DNS công cộng (-Server 1.1.1.1), và kiểm tra từ ít nhất hai nhà cung cấp DNS khác nhau. Nếu hai nhà cung cấp trả lời khác nhau, sự cố chưa kết thúc, dù máy tôi thấy ổn.
Sai lầm thứ hai: tôi sửa A record và đóng sự cố.
Bản ghi được trỏ lại đúng. Website hoạt động. Tôi báo cho khách "đã xử lý xong".
Ba ngày sau, một học viên báo không nhận được email xác thực. Kiểm tra thì ra bản ghi DKIM cũng bị mất trong cùng lần hỏng zone file — nhưng nó không gây lỗi gửi, nên không có gì báo cho tôi biết.
Từ đó, quy trình đóng sự cố DNS của tôi có thêm một bước bắt buộc: sau khi sửa, gửi một email thật tới một hộp thư ngoài hệ thống (Gmail chẳng hạn) và xác nhận nó vào hộp thư chính, không phải thư rác. Đây là bài kiểm tra duy nhất thực sự chứng minh chuỗi SPF/DKIM/DMARC còn nguyên vẹn.
Sai lầm thứ ba: tôi không phân biệt "phân giải được" với "hoạt động".
Trong một sự cố khác, bản ghi A trỏ về IP cũ. Nhưng IP cũ vẫn còn một máy chủ đang chạy — máy chủ của một dự án đã dừng từ lâu, vẫn còn bật. Nó trả về một trang 404.
Vì kết nối TCP thành công và HTTP trả về một mã hợp lệ, công cụ giám sát uptime của tôi báo xanh. Trong 6 giờ, hệ thống coi như "đang chạy", trong khi toàn bộ API đã hỏng.
Từ đó, mọi endpoint health check của tôi đều kiểm tra nội dung, không chỉ mã trạng thái:
// SAI — chỉ kiểm tra là có phản hồi
var ok = response.IsSuccessStatusCode;

// ĐÚNG — kiểm tra phản hồi có phải của CHÍNH hệ thống mình không
var json = await response.Content.ReadFromJsonAsync<HealthDto>();
var ok = json?.Service == "findme-cloud" && json.Version != null;
Trường Service là chốt chặn: nó khiến bất kỳ máy chủ nào khác trả lời cũng bị đánh dấu là sai. Không có nó, một trang 404 của dự án cũ vẫn được coi là "hệ thống khỏe".
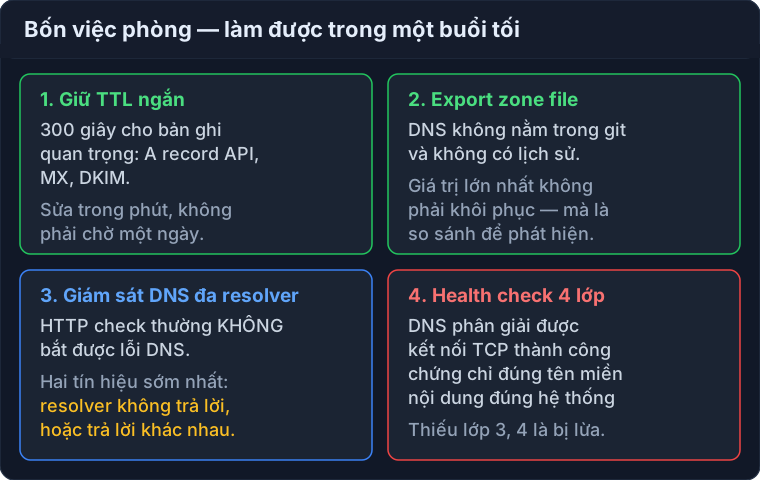
6. Phòng: bốn việc làm được trong một buổi tối
Sau sự cố đó, tôi làm bốn việc. Cả bốn đều rẻ, và cả bốn đều đã giúp ích ít nhất một lần.
Việc 1 — Hạ TTL trước khi đổi bất cứ thứ gì
Với những bản ghi quan trọng — A record của API, MX, DKIM — tôi giữ TTL 300 giây thay vì 3600 hay 86400.
Đánh đổi: số truy vấn DNS tăng lên, nhưng với một hệ thống nhỏ thì chi phí này không đáng kể. Nhận lại: khi cần đổi, thế giới cập nhật trong 5 phút thay vì một ngày.
Nguyên tắc: TTL ngắn là bảo hiểm. Bạn trả một ít hiệu năng liên tục để đổi lấy khả năng sửa nhanh khi cần.
Việc 2 — Export zone file, định kỳ, tự động
Bản ghi DNS là cấu hình không nằm trong git của bạn. Nó nằm ở bảng điều khiển của nhà cung cấp, và nó không có lịch sử thay đổi mà bạn đọc được.
Tôi export toàn bộ zone file mỗi tuần và lưu cùng mã nguồn:
# Xuất tất cả bản ghi qua API của nhà cung cấp DNS
$records = Invoke-RestMethod -Uri $dnsApiUrl -Headers $headers
$records | ConvertTo-Json -Depth 10 | Out-File "dns-backup-$(Get-Date -f yyyy-MM-dd).json"
Lợi ích lớn nhất không phải là khôi phục — mà là phát hiện. Khi bạn có file của tuần trước, bạn có thể so sánh và biết ngay bản ghi nào đã biến mất, thay vì cố nhớ xem trước đây có gì.
Việc 3 — Giám sát DNS như một dịch vụ, không chỉ giám sát HTTP
Đây là việc đã giúp tôi phát hiện sự cố sớm nhất.
Một health check HTTP thông thường không bắt được lỗi DNS, vì bản thân công cụ kiểm tra cũng dùng DNS — và nếu công cụ cache câu trả lời cũ, nó vẫn thấy hệ thống chạy.
Cách kiểm tra đúng: query DNS với nhiều resolver và so sánh kết quả.
$resolvers = @("1.1.1.1", "8.8.8.8", "9.9.9.9")
$ketQua = foreach ($r in $resolvers) {
    try {
        $ip = (Resolve-DnsName $tenMien -Server $r -Type A -ErrorAction Stop |
               Where-Object { $_.Type -eq 'A' }).IPAddress
        [pscustomobject]@{ Resolver = $r; IP = $ip }
    } catch {
        [pscustomobject]@{ Resolver = $r; IP = $null }
    }
}

$khacNhau = ($ketQua.IP | Where-Object { $_ } | Sort-Object -Unique).Count -gt 1
$thatBai  = ($ketQua | Where-Object { -not $_.IP }).Count

if ($thatBai -gt 0 -or $khacNhau) {
    # Đây là tín hiệu sớm nhất có thể có của một sự cố DNS
    Gui-CanhBao "DNS $tenMien bat thuong: $($ketQua | ConvertTo-Json -Compress)"
}
Hai tín hiệu đáng chú ý: một resolver không trả lời được, hoặc các resolver trả lời khác nhau. Cả hai đều xuất hiện trước khi người dùng phàn nàn.
Việc 4 — Kiểm tra chứng chỉ và nội dung, không chỉ mã trạng thái
Như đã nói ở phần sai lầm thứ ba: kết nối thành công không có nghĩa là đúng máy chủ.
Một health check đầy đủ cần kiểm tra bốn thứ:
1. DNS phân giải được (và nhất quán giữa các resolver)
2. Kết nối TCP tới cổng 443 thành công
3. Chứng chỉ TLS còn hạn VÀ mang đúng tên miền mong đợi
4. Nội dung trả về là của chính hệ thống mình (kiểm tra trường định danh)
Bỏ bước 3, bạn không phát hiện được việc mình đang nói chuyện với máy chủ khác. Bỏ bước 4, bạn không phát hiện được việc máy chủ đó trả về trang 404.
7. Checklist 12 điểm sau mỗi sự cố DNS
[ ] 1.  Bản ghi A đã trỏ đúng IP hiện tại chưa?
[ ] 2.  Kiểm tra qua ÍT NHẤT hai resolver công cộng khác nhau
[ ] 3.  Đã xoá cache DNS trên máy kiểm tra (ipconfig /flushdns)?
[ ] 4.  IP cũ giờ thuộc về ai? Có đang phục vụ nội dung khác không?
[ ] 5.  Bản ghi MX còn nguyên không?
[ ] 6.  Bản ghi SPF (TXT) còn nguyên không?
[ ] 7.  Bản ghi DKIM theo đúng selector còn nguyên không?
[ ] 8.  Bản ghi DMARC còn nguyên không?
[ ] 9.  Đã gửi MỘT email thật ra hộp thư ngoài và xác nhận vào Inbox?
[ ] 10. Webhook thanh toán đã được cổng thanh toán gọi lại thành công?
[ ] 11. ReturnUrl đã tải được và hiển thị đúng trang kết quả?
[ ] 12. Ứng dụng desktop/mobile đã kết nối lại được API chưa?
Ba điểm cuối là ba điểm hay bị bỏ nhất, và cũng là ba điểm liên quan trực tiếp tới tiền.
Nếu phải chọn ba điểm quan trọng nhất để làm trước, tôi chọn 2, 9 và 10. Điểm 2 đảm bảo bạn không tự lừa mình bằng cache. Điểm 9 xác nhận chuỗi email còn nguyên. Điểm 10 xác nhận luồng tiền còn thông.
8. Khi nào cần làm nhiều hơn sửa bản ghi
Có một trường hợp mà việc sửa bản ghi là chưa đủ: khi IP cũ đã bị người khác chiếm và phục vụ nội dung khác.
Trong trường hợp này, Google có thể đã thấy nội dung lạ dưới tên miền của bạn. Việc cần làm thêm:
Kiểm tra bằng chứng. Vào Google Search Console, xem phần Pages — có URL nào bị đánh dấu là thay đổi nội dung không. Nếu có, dùng công cụ kiểm tra URL để yêu cầu index lại.
Chủ động gửi lại sitemap. Đừng chờ Google tự quay lại. Việc gửi lại sitemap báo cho Google biết nội dung đã trở lại bình thường.
Ghi lại mốc thời gian. Nếu sau này có tranh chấp hoặc cần giải thích về biến động thứ hạng, một ghi chú có ngày giờ cụ thể sẽ hữu ích hơn nhiều so với việc nhớ lại.
Và một điều quan trọng về kỳ vọng: đừng mong thứ hạng trở lại trong vài ngày. Nếu có thiệt hại, thời gian hồi phục thường tính bằng tuần. Việc của bạn là đảm bảo hệ thống đã đúng, rồi để thời gian làm việc của nó.
9. Một cấu trúc giúp giảm thiệt hại
Có một quyết định kiến trúc giúp tôi trong mọi sự cố DNS: tách kênh thanh toán ra khỏi tên miền chính.
Cụ thể: webhook thanh toán không đi vào tenmien.com/webhook mà đi vào một subdomain riêng, có bản ghi A riêng, độc lập với trang chủ.
Lợi ích: khi trang chủ có sự cố DNS, luồng thanh toán không bị ảnh hưởng. Ngược lại, khi cần bảo trì hoặc đổi hạ tầng webhook, bạn không phải chạm vào bản ghi của trang chủ.
Nguyên tắc tổng quát: những đường đi liên quan tới tiền nên có bản ghi độc lập với những đường đi không liên quan tới tiền. Mỗi lần gộp chúng lại, bạn tăng xác suất một sự cố ở chỗ này làm hỏng chỗ kia.
Tương tự với email: nếu dùng subdomain riêng cho email giao dịch (mail.tenmien.com thay vì tenmien.com), sự cố ở tên miền chính không kéo theo email. Đánh đổi là thêm vài bản ghi cần quản lý — và tôi thấy đáng.
Câu hỏi thường gặp
Sửa bản ghi DNS rồi mà vẫn không vào được website, bao lâu thì lan truyền xong?
Bằng TTL của bản ghi đó. Nếu TTL là 300 giây, phần lớn thế giới cập nhật trong 5–10 phút. Nếu TTL là 86400, có thể mất tới một ngày. Nếu vẫn không được sau khoảng hai lần TTL, kiểm tra lại bằng resolver bên ngoài — rất có thể bạn đang nhìn cache của chính máy mình.
Làm sao xoá cache DNS trên máy để kiểm tra cho đúng?
Trên Windows: ipconfig /flushdns. Trên macOS: sudo dscacheutil -flushcache; sudo killall -HUP mDNSResponder. Trên Linux: tuỳ bản phân phối, thường là sudo systemd-resolve --flush-caches. Nhưng cách chắc chắn nhất vẫn là kiểm tra bằng resolver công cộng bên ngoài, không phụ thuộc cache của máy bạn.
A record và CNAME khác nhau thế nào, dùng cái nào?
A record trỏ trực tiếp tới một IP. CNAME trỏ tới một tên miền khác. Dùng A record khi bạn biết IP và nó ít đổi. Dùng CNAME khi bạn trỏ tới một dịch vụ có IP do họ quản lý — CDN, hosting PaaS. Một lưu ý quan trọng: không thể đặt CNAME ở bản ghi gốc của tên miền (tenmien.com), theo chuẩn DNS. Nếu cần, dùng bản ghi ALIAS hoặc ANAME do nhà cung cấp cung cấp.
Mất A record có làm mất luôn bản ghi MX không?
Không tự động. MX và A là hai bản ghi độc lập. Nhưng khi bạn chuyển nhà cung cấp DNS hoặc zone file bị hỏng, chúng thường mất cùng nhau vì cùng nằm trong một zone. Vì vậy hãy kiểm tra tất cả, đừng chỉ kiểm tra A.
Có nên dùng TTL rất thấp như 60 giây cho mọi bản ghi không?
Không. TTL quá thấp làm tăng số truy vấn DNS lên đáng kể, và với một số nhà cung cấp DNS miễn phí, điều đó có thể vi phạm hạn mức. Với một hệ thống nhỏ, 300 giây là điểm cân bằng tốt cho các bản ghi quan trọng. Với bản ghi ít đổi như MX, TTL dài hơn là hợp lý.
Làm sao biết email đang hỏng mà không có khách phàn nàn?
Gửi thử một email từ hệ thống tới một hộp thư bên ngoài bạn kiểm soát được (Gmail cá nhân chẳng hạn) và kiểm tra thủ công. Đây là cách duy nhất chắc chắn, vì log phía gửi không thấy được vấn đề. Ngoài ra, kiểm tra định kỳ bằng các công cụ kiểm tra SPF/DKIM/DMARC công khai để chắc chắn bản ghi còn tồn tại.
Nếu tên miền của tôi bị hết hạn thì sao?
Hậu quả nặng hơn mất một bản ghi: toàn bộ zone biến mất, bao gồm email và mọi subdomain. Website, email, API, webhook đều chết cùng lúc. Cách phòng duy nhất là bật tự động gia hạn và đảm bảo phương thức thanh toán còn hiệu lực. Với tên miền quan trọng, gia hạn nhiều năm để giảm số lần phải nhớ.
Có công cụ nào tự theo dõi DNS cho tôi không?
Có nhiều dịch vụ giám sát DNS. Nhưng điểm quan trọng khi chọn là: công cụ phải kiểm tra từ nhiều vị trí địa lý với nhiều resolver khác nhau. Một công cụ chỉ kiểm tra từ một máy sẽ bỏ lỡ tình huống các resolver trả lời không nhất quán — mà đó lại chính là tín hiệu sớm nhất của sự cố.
Kết luận
Một bản ghi DNS bị mất không phải là một sự cố website. Nó là bốn sự cố cùng lúc, và ba trong số đó hỏng âm thầm.
Ba điều tôi muốn bạn mang đi:
Hậu quả lớn hơn bạn nghĩ. Website chết là phần dễ thấy nhất và cũng ít thiệt hại nhất. Email hỏng và webhook không tới mới là phần mất tiền — và cả hai đều không báo lỗi.
Cache làm mọi thứ chậm hơn. Thời gian khắc phục bằng thời gian sửa cộng TTL. Hãy hạ TTL trước, và luôn kiểm tra bằng resolver bên ngoài thay vì tin vào máy mình.
Đừng tin mã trạng thái. Kết nối thành công không có nghĩa là đúng máy chủ. 250 OK không có nghĩa là email đã tới. Health check của bạn phải kiểm tra nội dung, không chỉ kiểm tra sự tồn tại của phản hồi.
Cuối cùng: sự cố DNS không phải chuyện "nếu" mà là chuyện "khi nào". Bạn không kiểm soát được lúc nào bản ghi biến mất. Bạn chỉ kiểm soát được mình biết nó biến mất trong bao lâu. Với một hệ thống nhỏ, khoảng cách giữa "5 phút" và "4 giờ 26 phút" chính là khoảng cách giữa một sự cố bạn xử lý và một sự cố khách phát hiện.
Đừng để phát hiện sự cố là việc của khách
Nếu bạn đang chạy hệ thống trên VPS và câu trả lời cho "làm sao tôi biết khi nó hỏng?" là "khách sẽ gọi" — đó là vấn đề cần giải quyết trước cả khi tối ưu tốc độ hay SEO.
FindMe VPS Guardian là hệ thống giám sát chủ động cho VPS chạy bot và backend: Agent đọc trạng thái máy và terminal, EA Watchdog đọc nhịp tim của bot, cảnh báo qua Telegram trong khoảng 30 giây, và xử lý từ xa một chạm khi bạn không ngồi trước máy.
- Dùng thử 7 ngày: chuyendoiso.digital/register
- Xem tính năng và bảng giá: chuyendoiso.digital/features
- Đọc tiếp các bài về vận hành: chuyendoiso.digital/blog